70强项目观察之具身未来:机器人走进现实世界,关键不只是完成动作
点击查看原文>
机器人叠一件衣服、抓起一个物体,或者在仿真地图中完成一段巡逻,都可以成为一个精彩 Demo。
但一旦进入真实世界,问题会迅速变复杂:物体位置会变化,光照和材质并不恒定,抓取偏差可能影响后续动作;地形也可能从平路切换到坡面和障碍,感知、规划与运动控制必须持续协同。
因此,具身智能真正要解决的,不只是“机器人能不能动起来”,而是能否在动态、并不完全可控的物理环境中持续感知、判断和行动,最终完成一项完整任务。
GOAI「具身未来 Embodied Future」20 支决赛团队分别进入双臂协作操作和全地形巡逻两类任务。从这些项目可以看到,具身智能正在从单次能力演示走向更完整的系统能力,闭环控制、三维空间理解、环境泛化和长任务执行,也由此成为共同面对的关键问题。
围绕“如何让机器人真正完成持续任务”,20 个项目呈现出几条具有代表性的技术演进路径。
趋势一:从一次动作预测,走向持续观察和持续重规划
现实环境不会因为机器人已经生成计划就停止变化。
TwinFlow-XR1 同时输入头部相机、双手腕相机、语言指令和双臂状态,由视觉语言模型理解场景和任务,动作专家承担连续动作预测,并在执行过程中持续重新观察环境、更新后续动作。
Lion-VLA 采用统一模型覆盖 12 类双臂任务,推理过程中每执行 8 步重新观察并规划,通过更短的闭环周期在动作连续性和纠偏之间取得平衡。
GOAI residual inference 则在基础 VLA 输出之后增加残差动作修正:系统结合机器人最近几步状态,对基础动作进行补偿,并限制修正幅度;遇到未支持任务则停止输出。
TeamGo 基于 Xiaomi Robotics 1 进行双臂操作适配,每次预测 15 步动作,执行前 10 步后重新观察并规划后续动作。系统同时加入动作平滑、位移与转角限制以及夹爪抖动抑制,希望减少动作突变,提升连续执行的稳定性。
这些不同技术路线背后有一个共同方向:都没有把动作生成视作一次性决策。
在真实操作中,“看到—行动—再看到”构成连续循环。机器人必须利用执行之后产生的新状态判断:物体是否真的抓住?位置是否已经偏移?前一步动作是否产生了预期效果?
因此,越来越多具身智能方案开始强化从动作预测到持续反馈、在线修正的闭环能力。真正重要的,不只是第一次动作预测有多准,而是系统偏了以后能不能重新找回来。
趋势二:从“识别物体”走向理解可行动的三维空间
传统视觉任务往往只需要回答“这是什么”。机器人还必须回答:它在哪里?离机械臂多远?应该从哪个方向抓?放在哪里才不会碰撞?
因此,多视角与三维空间表征成为多个双臂项目共同关注的问题。
基于 3D 几何特征解耦增强的 VLA 混合模型,在 Qwen3-VL 和 Diffusion Transformer 基础上加入视觉几何模型,从多相机画面估计物体距离、方向和位置,并通过 3D-MIX Bridge 把几何信息补充进动作决策。
mumu-go 同样接入头部和双手腕三路相机,一端获得整体环境信息,一端捕捉末端附近细节,并提高抓取、抬升和放置等关键时刻在训练中的比重。
RoboRush 也将头部与双腕多相机输入接入完整 VLA 工程链路,从数据处理、训练一直延伸到远程推理;HUST_HRT 则尝试以一套 LoRA 参数覆盖 12 类任务,在统一模型框架下减少多任务适配和部署成本。
这里反映出一个重要变化:空间理解开始从隐含能力变成显式能力。机器人需要的不只是语义——“这里有一个杯子”,而是与行动直接相关的空间关系——“杯子在什么位置,末端如何接近,抓取之后怎样移动”。
当 AI 从屏幕进入物理世界,几何关系本身就是任务的一部分。
趋势三:从固定环境中的成功,走向环境变化后的稳定完成
实验室 Demo 最大的优势,是环境通常可以被控制。真实环境恰恰相反。颜色、材质、反光和光照可能改变,物体位置会变化,视野可能被遮挡。模型如果只记住训练环境中的表面特征,很容易在现实中失效。
因此,越来越多项目开始把“环境发生变化以后还能不能完成任务”作为泛化能力的重要检验。
“草地牛_Robot”的方案专门改变训练数据中的物体材质、颜色、反光和光照,同时保持物体位置与动作轨迹不变,希望让模型学习“视觉外观变了,但正确动作没有变”。其数据由约 1200 段扩展到 4800 段、约 237 万帧,并进行关键缓存质量检查。
TEMP 团队则围绕三类典型问题改进 Baseline:通过关键帧加权强化抓取和放置,通过长时序信息增强缓解长任务漂移,通过随机遮挡降低模型对固定视觉特征的依赖。
这种对环境变化的适应,在巡逻项目中同样明显。“山猫巡游记”围绕山猫 S10 平台探索复杂园区中的跨地形巡逻;“维金战船”则利用轮足结构兼顾规则路面的移动效率与复杂地形中的障碍跨越能力。
这些项目让“泛化”变得更加具体。它不只是测试集里换一个样本,而是环境发生合理变化以后,机器人仍然能够抓住与任务真正相关的信息,并继续完成任务。
趋势四:从单项运动能力,走向完整任务系统
全地形巡逻把具身智能的另一面暴露得更明显。
机器人跨过一个障碍并不等于它能够完成巡逻;真正的任务要求它持续感知环境、规划路线、跨越不同地形,并按要求抵达目标点。
“智巡山猫”尝试将环境感知与运动控制融合,让地形信息直接参与机器人如何运动的决策。
Terrain-Aware Autonomous Driving with Adaptive Locomotion 同样把地形感知与自适应运动结合起来:环境信息不只用于识别,还要影响机器人在不同地形上的通行策略。
面向山猫 S10 的三维自主巡逻与跨地形导航系统,则进一步把三维环境理解、自主巡逻和跨地形导航组织进同一任务链。
其他巡逻团队也把重点放在“完成整项任务”而非单个动作上。Tashi Robot Run、炎熵润启、S10-PATROL 和 CAMSUCCESS 都围绕复杂园区中的持续自主巡逻组织整体方案,从仿真和代码验证向完整任务链推进;lidarencoder 修改版 SRU 则从激光雷达编码切入,为后续导航、避障和运动控制提供更有效的三维环境表征。
这些方案的共同变化,是不再把“导航”“越障”“感知”作为彼此孤立的 Benchmark。具身系统真正需要的是:感知环境—决定怎么走—执行运动—读取新状态—继续完成巡逻。
这意味着具身智能最终仍然是一个系统工程问题。单一模型再强,也必须与机器人平台、传感器、运动控制和任务管理一起工作。
从仿真到真机,是具身智能必须经过的一次关键验证
从双臂和全地形巡逻 20 个项目来看,具身智能正从“动作能力”走向“任务能力”:闭环重规划应对执行偏差,三维表征理解空间关系,数据增强提升环境适应,而完整任务系统则让这些能力持续协同。
但这些能力最终都要接受真实物理环境的检验。摩擦、执行偏差、传感器噪声和地形变化,都可能让仿真中的有效策略在真机上面临新的挑战。
因此,具身智能下一阶段的重要问题,不只是单项指标提升了多少,更在于机器人能否在动态环境中稳定完成完整任务,并在出现偏差后继续调整和恢复。
9 月 22 日至 23 日,世界人工智能开源大赛(GOAI)总决赛及 GOAI DAY 将在杭州举行。「具身未来 Embodied Future」赛道也将进一步进入真实任务检验。
当 AI 真正离开屏幕,答案将由每一次感知、行动、纠偏和真实反馈共同给出。
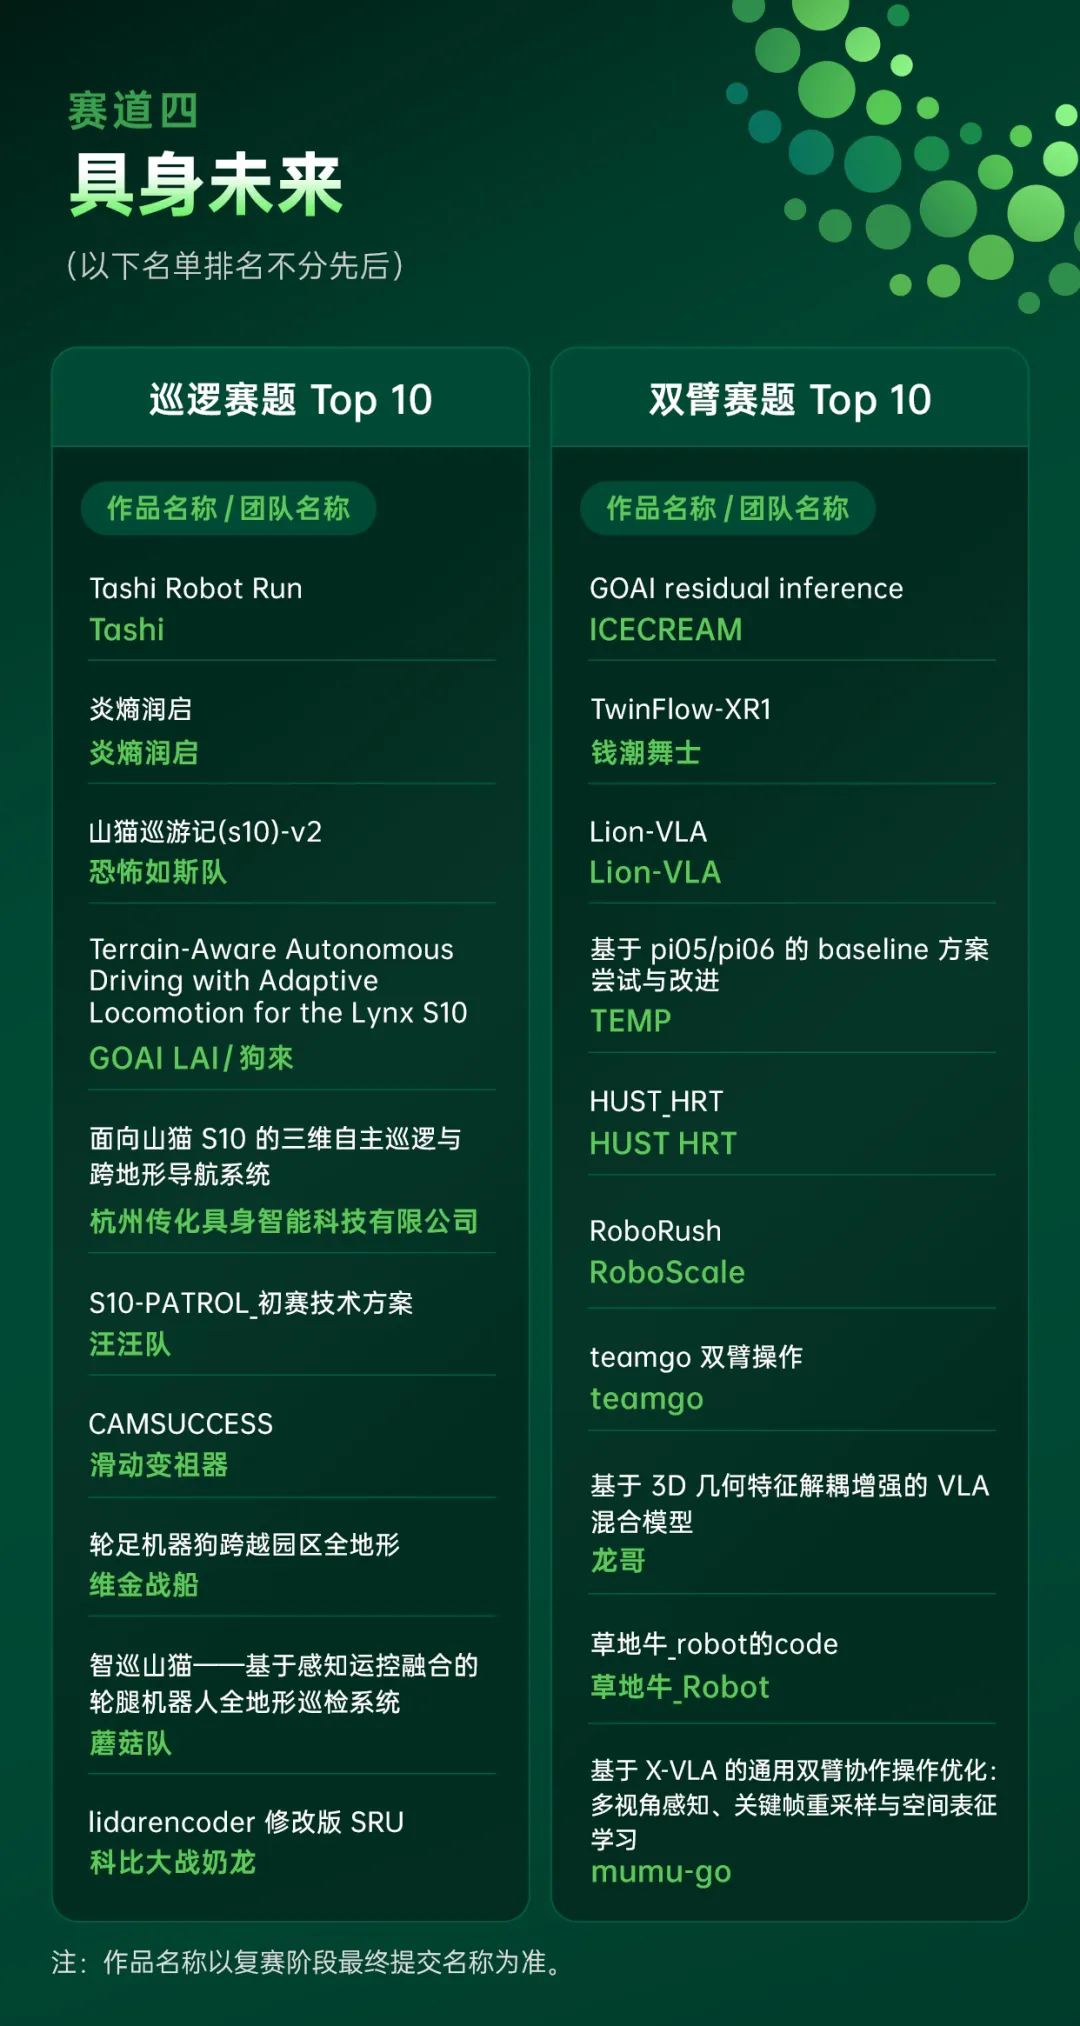
(具身未来 赛道 20 支决赛入围团队,排名不分先后)
本文来源:InfoQ