不下班的经营者:把 LLM-as-Judge 做成会自我校准的评估闭环|QCon上海
点击查看原文>
从「构建 AI」到「驾驭 AI」,100+ 实战案例拆解 AI Native 时代的工程新实践!
推理模型持续突破能力边界,Coding Agent 深度参与研发流程,Agent Runtime、Agent Framework 快速演进……AI 正在从回答问题的模型,演变为能够自主规划、调用工具、执行任务的软件系统。AI 不再只是软件中的一个能力,而开始成为软件系统的一部分。这意味着软件工程面对的挑战也发生了变化:团队需要思考的不再只是如何训练模型、模型、部署模型 或优化 Prompt,而不是如何让具备自主能力的 AI 稳定、可信、可控地运行。模型决定 AI 能做什么,系统决定 AI 能否真正创造价值。
在这一背景下,2026 年 QCon 全球软件开发大会大会 · 上海站正式启动。本次大会将于 10 月 22 日—24 日举办,聚焦 Harness AI 时代的工程实践,围绕 AI Native 架构、Agent Runtime、AI Infra、Data Systems、Agent 安全与可观测、Loop Engineering、Vibe Coding、具身智能与世界模型、端云协同等前沿技术方向,邀请全球技术社区与产业一线的实践者,系统性分享前沿洞察与实战经验,共同探索 AI 从能力到系统、从实验到生产的真实路径。
阶跃星辰开放平台产品负责人陶炳哲已确认出席 “AI Agent 可观测与持续改进工程” 专题,并发表题为《不下班的经营者:把 LLM-as-Judge 做成会自我校准的评估闭环》的主题分享。大多数团队的 Agent 停在「能跑一次」:demo 惊艳,上生产后开始悄悄跑偏——输出看着完整却没达标、反复调同一个工具烧 token 却零推进、结果对但过程越权。根因不是模型不够强,而是缺少独立评估闭环。本次分享拆解两条仍在生产运行的 Loop:一条每天自动产出会议纪要并自我进化,一条支撑开放平台「申请→自动开通→通知→日报」。核心是双层评估:生产 checker 打 94 分,每天另跑一个盲评 Meta-Evaluator 只给 85 分,偏差超过 8 分自动触发 rubric 校准;每周再用 Planner-Generator-Evaluator 三 Agent 做单变量对抗迭代,让系统自己升级并支持快照回滚。给出可复用的设计八问、三类隐性失控信号的监控方式,以及一串真实踩坑:prompt 层去重被 LLM 无视、写接口「假成功」、快照把磁盘和 inode 双撑爆、评估成本翻倍怎么权衡。目标是让你的 Loop 从「跑通一次」变成「连续跑对十次」。
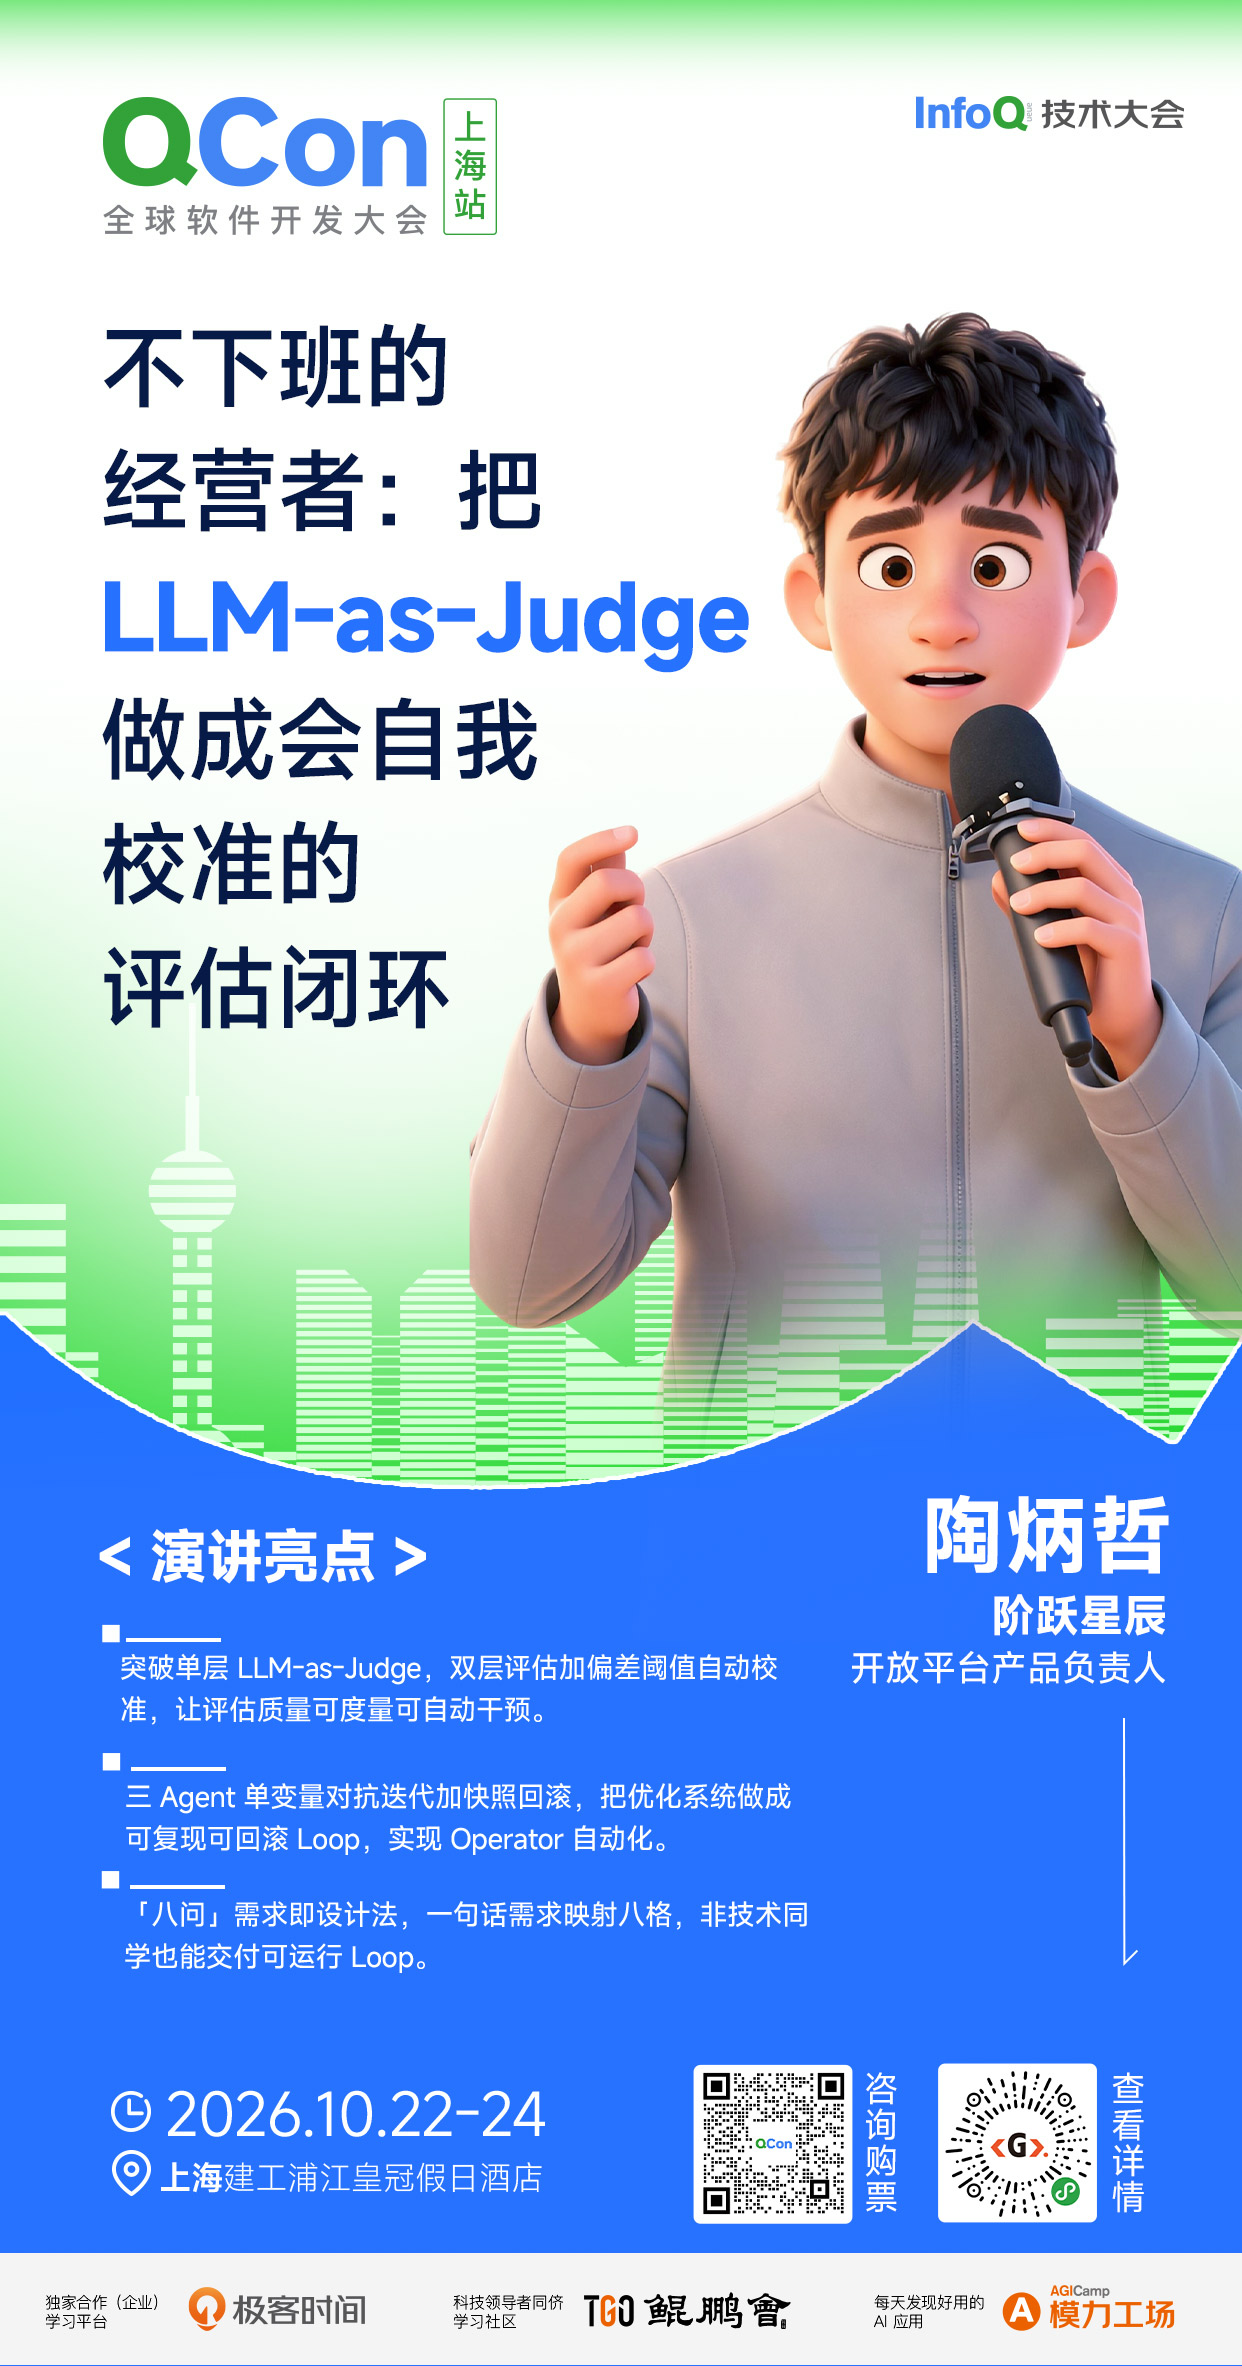
陶炳哲,阶跃星辰开放平台产品负责人,负责阶跃 Step 系列模型的对外开放平台、API 商业化与开发者生态,当前关注模型路由设计、token 商业化等产品方向。从阿里云可观测产品负责人,到字节跳动对内可观测产品负责人,再到现在的阶跃星辰开放平台产品负责人——十年时间,他一直在做同一件事:让系统自己能告诉你它怎么了。而现在,他要告诉你,怎么让 Loop 系统真正跑来,而不是跑飞了。他在本次会议的详细演讲内容如下:
演讲提纲:
开场|为什么「跑通一次」不等于能上生产
Agent 是能力,Loop 是系统:敏态 Agent(Codex / Claude Code 作为通用执行引擎)与稳态 Loop(目标、触发、验收可定义)的分界
一个反直觉判断:Loop 的门槛不是模型能力,是评估与信任架构
2. Part 1|案例拆解:一条会进化的会议纪要生产线
七块拼图:自动化触发(录音生成即启动)/ worktree 隔离 / Skill 场景模板 / MCP 连接日历·文档·IM / 子 Agent 分工(转写·总结·行动项·评审)/ 记忆库(让本周周会从上次接着开)/ 独立 Evaluator
前六块只保证「做出来」,第七块才保证「做对」
现场读看板:生产 checker 94 分 vs 盲评 Meta-Evaluator 85 分,两条线为什么必须分开
自动校准机制:偏差 > 8 分即触发 rubric 重校,并把偏差原因存为下一轮升级素材
自进化:每周 Planner → Generator → Evaluator 单变量对抗迭代 + 快照晋升/回滚 + HUMAN_GATE 人工闸门
3. Part 2|通用方法:设计一个 Loop 的八问,与它的自然顺序
①目标与完成态 ②触发与调度 ③上下文与 Skill ④工具与分工 ⑤隔离与安全 ⑥记忆与状态 ⑦评估与观测 ⑧身份与权限
顺序不能乱:先定义成功 → 再设计执行 → 最后补护栏
关键实现细节:Evaluator 只返回 PASS / REWORK / ESCALATE + 修改建议;模型分层(高频执行追成本,关键验收追可靠性);每个有副作用的动作必须有幂等键
30 秒现场套用:一句话业务需求(「表单新增申请就自动开通模型权限」)如何逐句落到八问的每一格
4. Part 3|踩坑实录:五个把我打醒的生产故障
约束只写进 prompt 就等于没写:去重逻辑交给 LLM 判断,结果被无视、纪要重复生成——必须回落到代码层 filter 兜底
写接口的「假成功」:清空多选字段传 null 返回 ok: true 但值没变;每次写入都要「写后复核」
空跑被误判为失败:0 篇输入时依赖 Agent 自己写结果文件,可靠性不足导致告警刷屏——静默成功也要有显式标识
自进化把磁盘撑爆:快照目录把根分区的容量和 inode 双打满,全链路自动化集体失败;配额/清理必须和自进化同步设计
凭证与额度是隐性单点:user token 静默失效、算力预算池月度耗尽(HTTP 402)——需要区分「可自愈态」与「真失效」,真失效自动推二维码/停止重试(每个坑都给出「现象 → 误判 → 根因 → 现在的兜底」四段式)
5. Part 4|三类隐性失控与信任架构
三类失控信号:过早宣布完成 / 装忙死循环 / 结果对但过程越权 → 对应监控结果质量、状态推进、过程合规三层
生产门槛四件事:稳定可恢复的运行载体(本地跑通的 demo 不是生产环境)、Agent Identity、最小权限(默认无权限、临时授予、用后回收)、全链路审计(模型/Prompt/工具调用/授权主体/成本)
6. 收尾|可带走的三条与起步建议
运动员 ≠ 裁判;先定义成功再设计执行最后补护栏;挑一个每周重复且结果可验收的小任务,让它连续稳定跑对十次
您认为,这样的技术在实践过程中有哪些痛点?
评估成本与覆盖率的 tradeoff:双层评估几乎让 token 成本翻倍。全量盲评太贵,抽样又会漏掉长尾问题。我目前的折中是「生产 checker 全量 + Meta-Evaluator 每日抽样盲评」,代价是偏差发现有最长 24 小时的滞后。
裁判自己也会漂移:LLM-as-Judge 的 rubric 会随模型版本和 prompt 微调而松动,谁来审计审计员?加第三层只是把问题推后一层,最终必须有人工闸门(HUMAN_GATE)兜底,这意味着「完全无人值守」是个伪目标。
自然语言约束不可靠:写进 prompt 的硬规则(去重、幂等、格式)会被模型在长上下文里无视。可靠的做法是把确定性逻辑退回代码层,但这样 Loop 就变「硬」了,牺牲了灵活性——哪些约束该硬编码、哪些该留给模型,没有标准答案。
自进化与稳定性天然冲突:让系统自己改自己(prompt、rubric、阈值)意味着回归难以复现。必须配快照晋升 + 一键回滚 + 单变量迭代,工程复杂度远高于「写一个 agent」,且快照本身会吃掉磁盘与 inode。
幂等 vs 及时性:状态列/state 文件去重能防重复副作用,但轮询增量模型下,边界数据(并发写入、跨天记录)仍会漏或重;把去重窗口放宽会牺牲及时性。
可观测性缺口:Agent 的失败大多是「语义失败」而非报错,传统 APM 和日志抓不到;trace 里能看到调用链,但判断「这次输出到底对不对」仍要额外一次模型调用,观测本身就是成本。
凭证与配额是被低估的运维成本:无人值守系统里,token 过期、额度耗尽、机器磁盘满这类「非 AI 问题」,占了我实际故障的一半以上。
演讲有哪些前沿亮点?
双层评估 + 偏差阈值自动校准(业界多数停在单层 LLM-as-Judge)
常见做法是用一个 judge 给输出打分,但 judge 与执行同源、且尺子会自己变松。我的方案是在生产 checker 之上再架一个每日盲评的 Meta-Evaluator,用两条分数线的偏差(94 vs 85)作为可监控指标,偏差超阈值(8 分)就自动触发 rubric 重校,并把偏差原因沉淀为升级素材——把「评估质量」本身变成了一个可度量、可自动干预的信号,而不是靠人定期抽查。
2. Planner-Generator-Evaluator 三 Agent 单变量对抗式周迭代 + 快照晋升/回滚
把「优化 Agent 系统」这件事也做成 Loop:每周由 Planner 提出单变量改动、Generator 实施、Evaluator 独立判优劣,通过则快照晋升,不通过则回滚,并保留人工闸门。相比手工调 prompt,它让系统升级变成可复现、可审计、可回滚的工程流程——这是把 Operator(经营者)这个角色自动化,而不只是把执行自动化。
3. 「八问」需求即设计法:让不写代码的产品/业务同学也能交付可运行 Loop
一句话业务需求逐句映射到目标·触发·上下文·工具·隔离·状态·评估·权限八格,拆清楚即可交给 coding agent 实现。已在两个真实场景(会议纪要、开发者权限开通)验证通用性——它的价值不是方法论漂亮,而是把「Agent 落地卡在谁来设计」这个组织问题解掉了。
除此之外,本次大会还策划了Loop Engineering、千行百业 Agent 创新实践、Agent 自主进化:从记忆到持续学习、Agent as a Service、Vibe Coding 时代的新质量债、理性驾驭 AI 的 SRE 可靠性工程、金融 AI Native工程实践:从研发提效到业务破局、AI Infra:算力效率决定规模化落地、AI Native 架构等 20 个专题论坛,届时将有来自不同行业、不同领域、不同企业的 100+资深专家在现场带来前沿技术洞察和一线实践经验。
查看更多详情可扫码或联系票务经理 18514549229 进行咨询。
本文来源:InfoQ