生产级大模型平台工程实战手册
点击查看原文>
在我们将基于 LLM 的库存推荐系统投入生产运行的第一个月末,约 15% 的智能体返回结果是幻觉——听起来言之凿凿,但内容毫无事实依据。
六个月后,幻觉率降到了 1.5%。推动这一数字下降的关键,并非换用更强大的基础模型,而是我们做出的一个决定:不再将大模型相关能力视作应用层的业务问题,而是把它当作平台基础设施来对待。
本文所描述的项目,是一家大型零售企业的库存准确性平台。系统库存记录会因错放、损坏、盗窃和计数错误而与货架实际商品产生偏差,这种偏差会影响下单、补货以及商品供给。
我们的多智能体大模型系统对数百万 SKU、数十亿条历史库存记录中的异常信号进行分析,为业务方生成库存修正建议,助力业务始终保持库存数据准确。
本文描述的平台层,由业务、产品、软件工程师、数据科学家、数据工程专家共同构建,目前服务于数十个应用团队,覆盖库存审计、补货审查、差异分诊等场景。
本文记录了这次架构转型——面向企业级流量,对 Gemini、GPT 等基础模型进行统一路由与治理。下文中的这些工程范式正是我当初希望项目上线第一天就能拥有的。
文中提到的所有基础组件,都在配套的 GitHub代码库中提供了实现,代码刻意设计为无隐藏抽象层。很多框架会用装饰器或内置智能体封装底层逻辑,而这个代码库把内部运作逻辑全部暴露,保证这些工程范式清晰易懂。
本文中的代码片段均直接取自该代码库。代码库和生产环境有一处刻意设计的差异:代码库通过 Ollama 运行本地模型 llama3.1,使用 LiteLLM 对接,而非调用云端托管基础模型。整个方案可以端到端本地运行,无需任何 API 费用。
为什么独立的 LLM 应用在规模化后会失效
几乎所有团队都会遇到高度相似的故障模式,甚至可以预判:原型能跑,首次生产环境部署,在一周内看起来一切正常。随后,那些评估阶段不会暴露的问题开始出现在监控面板上。
在我们的案例中,测试阶段暴露出了三类问题,每一类都是原型阶段没有覆盖到的场景。第一个是 LLM API 限流。在真实请求量下,我们开始被模型厂商限流。第二个是上下文问题。当系统推荐了不合适的商品时,根因几乎都是输入模型的数据,而非模型本身——这说明健壮的数据工程管线是解决问题的核心。第三个是大问题:幻觉。单次看很罕见,但在生产流量持续请求下,幻觉会稳定出现。我们在平台中设计了监控能力来追踪这些故障,正是这种可见性把每一个问题从谜团变成了可修复的对象。
追踪这些问题后,我们也清楚地明白:这些问题应当放在平台层统一处理,而不是交给单个应用。有三点特性尤为突出:
幻觉是输出问题,而非程序 Bug 幻觉返回的内容不会抛出调用栈异常,所有传统健康检查都能通过。下游服务接收结果并据此执行操作,很久之后才有人发现这个推荐结果对应的事实根本不存在。
Token 消耗不可控如果没有按请求归属统计用量,每月收到的账单就只有服务商给出的一行总金额。无法区分是哪个应用、哪个团队、哪个场景产生的开销,成本优化只能靠猜测。
行为不可观测延迟监控面板显示 P99 延迟正常,错误率接近 0。但模型输出质量在悄无声息地变差,但输出内容在语法上依然合法。
这些都不是应用程序的 Bug。几乎所有做大模型功能的团队都会碰到同类问题,大家第一反应都是在应用内部进行修复,于是 N 个团队写出 N 份重复的脚手架代码。这部分通用能力本应该下沉到平台层统一实现。
搭建共享大模型平台的理由
集中管理大模型能力并不是纸上谈兵。这和大型系统中集中管理身份认证、日志、服务网格的逻辑几乎完全一致:当多个应用存在同样的跨模块通用需求时,重复开发的成本会超过搭建共享基础设施的成本。
对 LLM 而言,共享的关注点是:
重试逻辑与故障分类
提示词注册表与版本管理
Schema 强制约束
按请求统计 Token 成本
行为可观测性
工具调用与上下文路由
跨工具服务的身份认证与授权
还有一个比重复更重要的二阶效应。共享平台强制形成契约,应用声明它们需要什么(即模型、提示词版本、Schema、工具集、评估引擎),平台负责交付。正是这种契约让新应用几天内就能上线,因为最难的部分已由平台解决。
搭建这个平台的决策点不是第一个 LLM 应用上线,而是第二个。等到十个团队都各自上线大模型功能后再在底层改造搭建平台将会是漫长艰难的迁移工作。
平台架构
图 1 展示了各个基础组件之间的组合关系。代码库实现了完整请求路径,与生产环境架构保持一致。
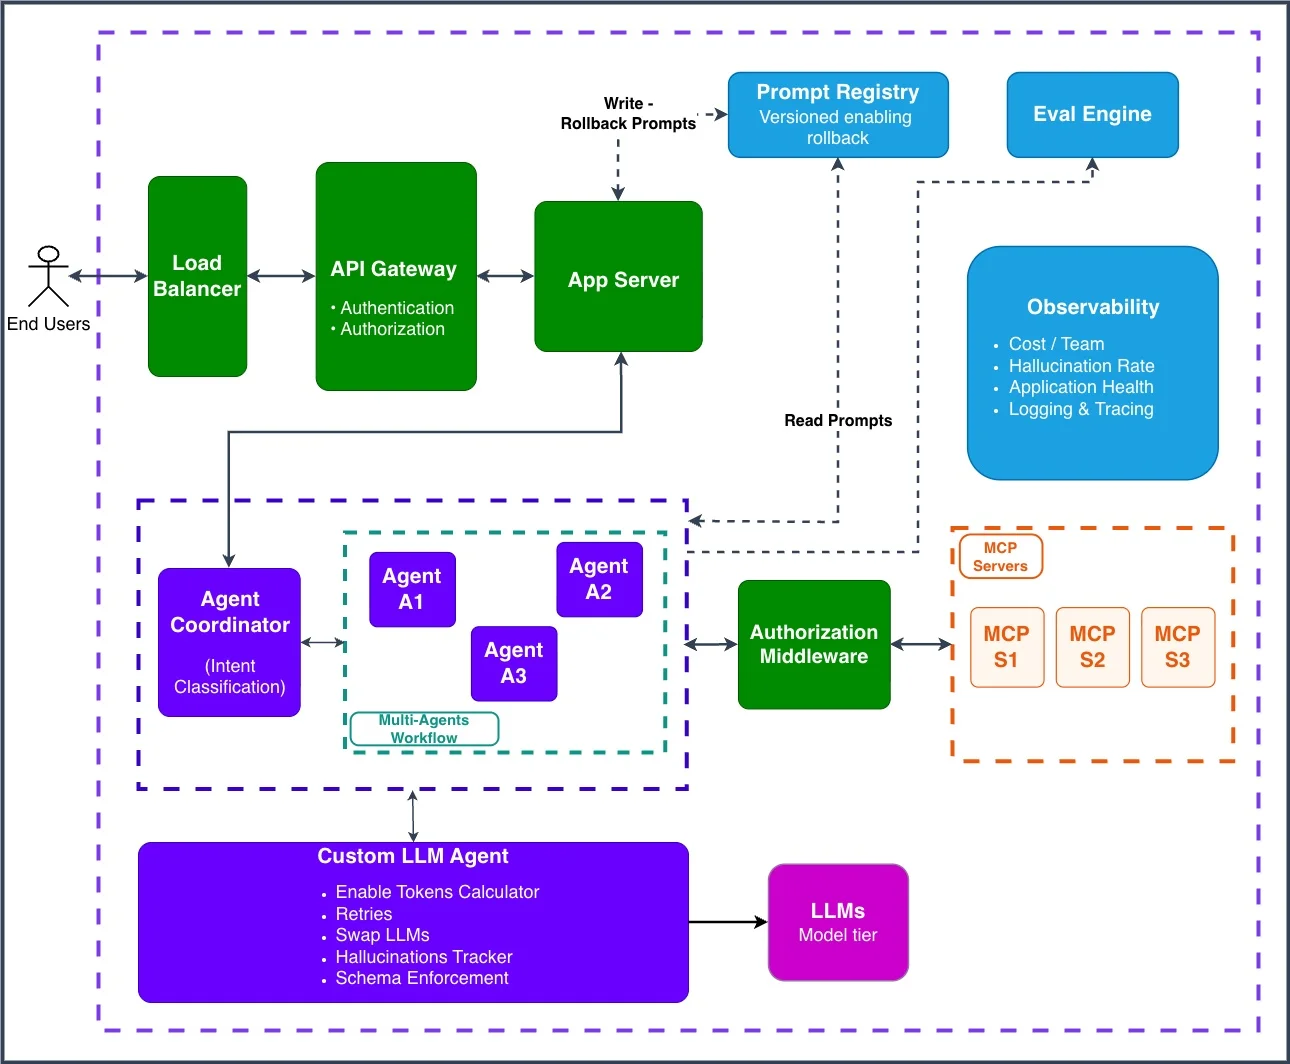
唯一入口是网关。网关负责调用方身份认证、签发携带角色信息的 JWT、暴露智能体执行接口、提供用户/团队维度指标、提供仅管理员可用的提示词回滚接口。网关后方,一个基于谷歌智能体开发套件ADK构建的根协调智能体在每一轮请求中识别意图,并将任务分发给一个或多个专家智能体;每个专家智能体绑定注册表中指定的提示词与结构化输出 Schema。专家智能体负责工具连接,对应多个独立的 MCP 服务,按团队或场景隔离;每个服务器在工具运行前自行验证调用方令牌并执行授权策略。
编排能力通过 ADK 实现:它提供智能体与子智能体拓扑结构、协调器分发给专家智能体的委托调用,同时提供回调钩子,平台在此记录调用成本与延迟。
所有智能体通过 LiteLLM 调用模型,这样可以随意切换模型厂商。本地调试时智能体可以调用本地模型,在生产环境中可以切换为 Gemini 或 GPT 等云端基础模型,仅修改模型标识即可。
配套代码库中的本地模型由 Ollama 提供,因此网关、智能体、工具服务都可以在笔记本上端到端运行,无 API 调用费用。
工具服务基于模型上下文协议部署。ADK 的 MCP 客户端连接智能体与团队侧服务,团队侧服务使用 FastMCP 构建。
这种分层解耦的价值在于:没有哪个单独的框架会垄断整个系统。模型层、工具层、编排层各自基于稳定接口,任意一层都可以替换,比如更换更强的模型、不同的工具服务、甚至是编排引擎,都无需重写平台基础组件。这就是依赖层面贯彻“无隐藏抽象”原则:每个工具只负责一件事,组件间调用路径清晰可见。
结构化输出:在平台层强制校验 Schema,并在失败时重试
我们所做的性价比最高的改变是在平台边界而非应用边界强制结构化输出。
这个模式的逻辑并不稀奇。每次调用大模型时声明目标 Schema(我们使用 Pydantic 模型),平台在校验通过后才将结果返回调用方。如果校验失败,平台会把校验错误作为提示词附加上下文重新发给模型,重试次数上限可配置。
把这个模式放在平台层而非各个应用中所带来的变化:
一个实现统一处理所有 Schema 不匹配问题,优化一次,所有应用受益。
下游调用方可以依赖这个契约:只要调用成功返回,输出结构一定符合规范。
Schema 违规会成为平台监控指标,而不是深埋在应用日志里的运行时异常。
我们的输出 Schema 不只是格式化数据,它也是给模型的显式指令,包含专门为隔离和度量幻觉而设计的追踪字段。图 2 展示了文档专家智能体的输出 Schema 示例。
from pydantic import BaseModel, Fieldclass DocsOutput(BaseModel):"""Result of a grounded documentation lookup."""answer: str = Field(description="The answer, grounded entirely in the fetched documentation.")sources: list[DocSource] = Field(default_factory=list,description="Documentation sources cited; empty only when nothing was fetched.",)grounded: bool = Field(description="True if every claim is backed by the fetched docs; ""False if the docs did not cover the question.",)out_of_scope: bool = Field(default=False,description="True if the request fell outside documentation lookup.",)
图 2. DocsOutput Schema(app/model.py)
图 3 展示模型满足该 Schema 后返回的样例结果。answer 字段填充回答内容,sources 列出回答引用的文档来源。当且仅当这些来源被拉取并使用时,grounded 标记为 true。如果问题不在文档覆盖范围内,返回同样的结构,但 grounded 为 false,sources 为空。平台将该结果标记为幻觉信号,而不是直接把这个看似自信的答案放行。
{"answer": "FastAPI's APIRouter lets you group related path operations and mount them on the main app with app.include_router().","library_name": "FastAPI","version": "0.115","sources": [{"library_id": "/tiangolo/fastapi","topic": "routing"}],"grounded": true,"out_of_scope": false}
图 3. DocsOutput 响应示例
grounded 和 out_of_scope 标记的生成成本为零,但强制模型以机器可读的形式承诺其答案是否有检索上下文支撑。校验失败、结构错误、字段缺失、无法解析的输出是平台识别幻觉精度最高的信号。
grounded 标记有意义的前提是模型在生成响应前发生了什么。所有专家智能体接入平台 MCP 服务器,模型仅能使用工具返回的信息作为事实依据。根智能体的指令中明确规定:工具返回结果是答案的唯一可信来源。
文档智能体是最好的例子。它的提示词中包含两个串行的文档工具:一个根据库名查询 ID,另一个根据库和主题拉取最新的官方文档。工具使用规则很严格:智能体必须先获取文档才能回答任何关于 API 或参数的问题,不能依赖可能过时的训练数据。所有结论、代码示例、参数名称都必须来自拉取到的文档。如果文档没有覆盖到这个问题,智能体必须如实说明,不能猜测。
Schema 随后会让模型展示推理过程。sources 字段记录每一次检索,只有全部结论都来自工具返回的内容时 grounded 才为 true。这个模式适用于所有专家智能体。当执行智能体报告部署信息时,其论断来自 MCP 工具的响应,而非模型的记忆。这里的锚定并非提示词层面的小技巧,而是完整的流水线:工具拉取证据、提示词约束模型只能基于证据回答问题、Schema 强制要求模型作出声明、校验机制把无效的声明转为可统计、可重试的失败任务。
严格的输出 Schema 校验能够把模糊的 AI 故障转化为明确、结构化的数据事件。只需借助单个 Pydantic 模型就可以获得进行重试、指标统计、评估所需的全部信号。
带校验的重试编排
这一层是将幻觉率从 15% 降到 1.5% 的关键,因此值得更详细地讨论。
盲目重试失败的大模型调用反而有害。直接重跑产生幻觉的提示词只会得到另一个幻觉。故障期间简单粗暴的重试会引发流量风暴,压垮基础设施。
对我们有效的模式是:
故障分类
究竟是 Schema 违规、幻觉信号(置信度低、内容缺乏事实依据或是生成结果偏离意图),还是基础设施错误(超时、触发速率限制或是模型不可用)?这三类问题需要采用三种不同的处理方式,将它们笼统合并为通用重试逻辑是错误的做法。
按类别进行路由
Schema 校验失败:把错误信息追加进提示词,让模型能清楚看到出错点(例如 grounded 返回字符串 yes 而不是布尔值,或者缺少必填的 sources 字段)。幻觉信号:使用更强的锚定上下文进行重试(例如文档智能体返回 grounded:false,或是引用了不存在的库文档来源)。基础设施故障:指数退避重试(例如服务商返回 429 限流、503 服务不可用,也就是我们上线初期遇到的节流问题)。
为单次请求设置重试上限
如果重试没有上限,一个异常请求会导致无限重试,产生巨大的开销,因此每个请求必须设置硬上限。有几种配置方式:最简单是固定重试次数,我们设为 3 次;如果第三次校验还失败,第四次几乎也无法自行修复。另一种方式是限制单次请求总 Token 消耗,控制实际的成本,而不是重试次数——长输入一次的重试开销可能超过短输入三次重试。第三种是时间上限,适合优先保证响应速度而非完整结果的场景。以上方案任选其一即可,关键是必须存在这些限制并且强制执行,避免单个请求无限重试。
平台不会直接吞掉畸形的数据并返回无效的对象,而是封装智能体的执行循环,捕获校验错误,记录为幻觉并触发智能重试。
智能体封装自身的运行循环,捕获结构异常输出抛出的 ValidationError,将每一次失败尝试记录为幻觉,并在达到可配置的重试上限后向上抛出异常,如图 4 所示。
from google.adk.agents import LlmAgentclass CustomLlmAgent(LlmAgent):def __init__(self, *args, max_validation_retries: int = 3, **kwargs):super().__init__(*args, **kwargs)self._max_validation_retries = max_validation_retries@propertydef max_validation_retries(self) -> int:"""How many times structured-output validation is retried before failing."""return self._max_validation_retriesasync def _run_async_impl(self, ctx):"""Run the agent with retry logic for validation errors.Both structured-output paths raise pydantic.ValidationError frominside ADK's _run_async_impl. This wrapper retries on validationerrors up to max_validation_retries times, logging each failurebefore retrying."""for attempt in range(self.max_validation_retries):try:async for event in super()._run_async_impl(ctx):yield eventreturn # Successexcept ValidationError as exc:is_last_attempt = attempt == self.max_validation_retries - 1logger.warning("[%s] VALIDATION ERROR (attempt %d/%d): output failed %s validation ""(%d error(s)): %s%s",self.name,attempt + 1,self.max_validation_retries,getattr(self.output_schema, "__name__", "?"),exc.error_count(),exc.errors(include_url=False)," -- retrying..." if not is_last_attempt else " -- max retries exceeded",)metrics.record_hallucination(get_current_user())if is_last_attempt:raise # Re-raise on last attempt
图 4. CustomLlmAgent重试循环(app/agent.py)
我们会记录每一次失败尝试,保证幻觉相关指标完全透明,并且在最后一次重试失败时抛出硬性异常,确保调用方永远不会收到静默返回的有问题的数据。
工具调用失败采用完全不同的处理机制。当 MCP 工具报错时,原始的错误信息会直接送入模型的上下文窗口,让模型能够自行修正并重新发起调用。这个循环交给 ADK 内置插件处理,在应用层完成注册,见图 5。
from google.adk.plugins import ReflectAndRetryToolPluginapp = App(root_agent=root_agent,name="app",plugins=[ReflectAndRetryToolPlugin(max_retries=3),],)
图 5. ReflectAndRetryToolPlugin 注册(app/agent.py)
我们将工具的恢复逻辑交由框架处理,因为工具返回的失败信息对模型来说已经是结构化的数据,但 Schema 校验由我们自行严格管理(使用 Pydantic)。把校验逻辑封装隐藏起来会破坏我们核心的幻觉遥测能力。
我们在这一层追踪两个关键指标:恢复率(验证重试循环是否有效)和放大系数(保证重试成本可控)。
提示词的版本和变更管理
把提示词变更视同代码变更。提示词是可执行文本,修改提示词会改变系统运行时行为,而这类变化在代码差异对比中无法直观体现。两段提示词哪怕只差一句话,也可能出现显著不同的幻觉率、延迟特征和 Token 开销,而且没有编译器可用于提醒新版本效果变差。
平台的最小基础原语:每一个提示词都有唯一 ID 和版本,并且可以独立于调用它的应用代码进行部署。应用通过 ID 引用提示词,而不是直接使用字符串字面量。平台保存提示词的各个版本,记录线上生效版本,并提供回滚能力,无需重新部署应用。
每个提示词在注册时都包含名称、显式版本、内容、创建时间和标签。注册新版本不会覆盖旧版本,而是追加历史记录,并更新线上版本指针。图 6 展示了 docs_agent 的两个版本:原始的 v1.0.0 版本和替代它的 v2.0.0 版本。
# Docs Agent Prompt -- v1.0.0 (registered first so v2.0.0 below stays active;# kept available as a rollback target).register_prompt(name="docs_agent",content="""You are a documentation lookup specialist. Your role is to:- Answer questions about software libraries and frameworks- Look up APIs, parameters, and usage patterns from their docs- Ground every answer in the documentation, not from memory- Say so explicitly when the docs do not cover a question- Keep answers concise and cite the library/version used""",version="1.0.0",tags=["documentation", "lookup", "specialist"])# Docs Agent Prompt -- v2.0.0 (active)register_prompt(name="docs_agent",content="""You are a documentation lookup specialist. Your job is to answer questions about software libraries and frameworks using their current, official documentation -- never from memory.You have two tools, used in sequence:1. resolve-library-id -- pass the library or framework name (e.g. "next.js", "fastapi") to get its Context7-compatible library ID. If the name is ambiguous and several libraries match, choose the one that best fits the user's context and state which you picked.2. get-library-docs -- pass the resolved library ID, plus a topic when the question is about a specific area (e.g. "routing", "middleware", "authentication"), to retrieve the documentation.Rules:- ALWAYS resolve and fetch docs before answering any question about a specific API, parameter, version behavior, or usage pattern. Do not rely on training data for library details, which may be outdated.- Ground every claim in the fetched documentation. When you give a code example or name a parameter, it must come from the docs you retrieved, not from memory.- If the fetched docs do not cover the question, say so explicitly rather than guessing. Do not fill gaps with plausible-sounding but unverified API details.- If you cannot resolve the library at all, tell the user the library wasn't found and ask them to confirm the exact name.- Keep answers concise and cite which library/version the docs came from.You do not author new documentation, run code, or search the open web. If a request falls outside documentation lookup, say it's out of scope for this agent.Output format -- return a single JSON object matching the DocsOutput schema:- answer: your grounded answer, drawn only from the fetched docs.- library_name: the library the answer is about (e.g. "FastAPI").- version: the library version the docs reflect, or null if unknown.- sources: one entry per docs lookup, each with the resolved library_id and the topic (or null).- grounded: true only if every claim is backed by the fetched docs; false if the docs did not cover the question.- out_of_scope: true if the request was not a documentation lookup.Do not include any text outside the JSON object.""",version="2.0.0",tags=["documentation", "lookup", "context7", "grounded"])
图 6. docs_agent 提示词的 v1.0.0 和 v2.0.0 版本(prompt_registry/prompts.py)
回滚不是删除,而是切换生效版本,完整历史仍然保留,向前滚动和回滚一样快速,见图 7。
def rollback(self, name: str, version: str) -> str:"""Repoint a prompt's active version to an existing earlier version.History is never deleted -- rollback only changes which versionget_prompt(name) returns. Returns the version now active. RaisesKeyError if the prompt or target version is unknown."""if name not in self._prompts:raise KeyError(f"Prompt '{name}' not found in registry")if version not in self._prompts[name]:raise KeyError(f"Version '{version}' not found for prompt '{name}'")self._latest_versions[name] = versionreturn version
图 7. rollback() 方法(prompt_registry/registry.py)
无需重新部署即可让回滚生效的关键在于智能体这一侧。每个智能体都会在运行时从注册中心解析获取指令,而不是在实例化时就固定捕获一段字符串,见图 8。
def _prompt_provider(name: str):# Resolve at run time (ADK InstructionProvider) rather than capturing a# fixed string at construction, so a prompt rollback via the registry# takes effect on the next request without rebuilding the agents.return lambda _ctx: get_prompt(name)
图 8. _prompt_provider运行时指令提供器(app/agent.py)
基于这种查询机制,运维人员调用回滚端点即可改变下一个请求的行为,无需部署、重启或重新构建。回滚端点是仅管理员可访问的网关接口,因此用于控制工具访问的 RBAC 层也可控制谁可以修改线上的提示词。
这里有一个实实在在的局限,也是我接下来打算进行优化的地方:注册中心会将提示词保存在内存中。这种方式用于演示和本地开发没有问题——在这些场景下,你希望直接读取代码并运行,无需引入外部依赖,但它不适用于生产环境。生产环境中,提示词数据必须在服务重启后依然保留,并且在多实例之间保持一致。生产环境的方案是:同一接口接入数据库,为每个环境(例如开发环境、预发布环境和生产环境)设置独立的版本绑定。上层调用代码完全不变,仅替换底层存储。
意图验证作为路由网关
这是我们架构中最具创新性的基础组件。在发起成本高昂的基础模型调用前,意图校验会完成一个判断:这个请求是否属于平台可处理范围,如果是,交给哪个专家智能体处理?在生产环境中,我们在基础模型前部署轻量训练分类器,可以用 Hugging Face 的调优 Transformer,或是用 scikit-learn 训练轻量模型。但架构并不强制要求分类器必须是训练得到的模型。关键在于:在路由之前有一套独立、低成本、可审计的判断逻辑,输出结构化的判断结果。代码库里刻意实现成了确定性的网关,方便理解底层逻辑。最重要的一点是,当没有匹配项时不进行猜测。图 9 是网关代码。它基于 YAML 关键词规则对智能体进行打分,如果没有达到阈值就返回“未分类”,而不是默认选择得分最高的智能体。
def classify_intent(user_input: str) -> Dict:"""Classify user intent based on YAML keyword rules.Returns a structured decision the calling agent can act on:- matched: {"status": "classified", "agent": <name>, "score": <float>}- no match: {"status": "unclassified", "agent": None, ...}The request is left unclassified rather than defaulting to afixed agent; the caller decides or asks the user."""user_input_lower = user_input.lower()agent_scores = {}for agent_name, agent_rules in INTENT_RULES.get("agents", {}).items():keywords = agent_rules.get("keywords", [])weight = agent_rules.get("weight", 1.0)score = sum(1 for kw in keywords if kw in user_input_lower) * weightagent_scores[agent_name] = score# No confident match: do NOT default to a specific intent. Hand control# back so the platform can ask the user or fall through to a grounded path.if not agent_scores or all(score == 0 for score in agent_scores.values()):return {"status": "unclassified","agent": None,"reason": "No intent rule matched the request.","available_agents": list(INTENT_RULES.get("agents", {}).keys()),"next_action": "ask_user_about_web_search",}best_agent = max(agent_scores, key=agent_scores.get)return {"status": "classified", "agent": best_agent, "score": agent_scores[best_agent]}
图 9. classify_intent 网关(intent_classifier/classifier.py)
即使匹配度很低,普通路由也会强行把请求交给得分最高的智能体,这正是智能体处理不属于自身能力范围问题、产生幻觉的根源。平台显式返回“未分类”,选择更安全的后续动作:拒绝请求、要求用户澄清,或是降级到严格受限的检索。
这能带来双重收益。网关可以拦截那些模型容易产生幻觉的请求。此外,由于预先选定合适的工具与提示词,缩小了模型需要检索推理的范围,从而降低了幻觉率,还能让上下文保持简短清晰。
我们将路由器设计为独立、可替换的组件,你可以灵活选择在基础模型前端使用简易关键词网关还是精度更高的训练分类器,例如通过 Hugging Face 微调的 Transformer 或是用 scikit-learn 构建的轻量模型。
身份认证与授权:保护 MCP 层
大多数文章都将智能体安全视为提示词注入问题。但在多团队部署场景中,更重要的问题反而更简单:当多个团队的工具部署在 MCP 服务器之后并且平台由多种角色共用时,_哪些调用方可以调用哪些工具?_就是 RBAC。它应当放在平台层实现,在资源服务端执行权限校验,而不是在每个应用里分别做访问控制。
平台在登录时签发无状态 JWT,使用 PyJWT 签名。令牌中携带调用方角色声明,任何持有共享密钥的服务都可以校验令牌并读取角色,无需回调认证服务。图 10 展示了平台签发令牌的逻辑:将调用方身份、角色写入短期 JWT,下游服务可使用共享密钥完成校验。
def issue_token(username: str, role: str, ttl_seconds: int = TOKEN_TTL_SECONDS):"""Mint a signed token for an authenticated user."""now = datetime.now(timezone.utc)payload = {"sub": username,"role": role,"iat": int(now.timestamp()),"exp": int((now + timedelta(seconds=ttl_seconds)).timestamp()),}token = jwt.encode(payload, JWT_SECRET, algorithm=JWT_ALGORITHM)return {"token": token, "token_type": "Bearer", "role": role, ...}
图 10. issue_token 函数(gateway/authz.py)
权限配置放在 YAML 文件,而不是硬编码规则,采用默认拒绝策略。修改安全策略仅需修改配置,不需要完整重新部署。图 11 为策略配置示例。
developer:description: Development-only access (no production)permissions:tools:- read_file- list_directory- query_databaseresources:- "file://src/*"- "db://dev/*"- "db://staging/*"operations: [SELECT, GET, LIST]# Explicitly blocked: production databases, deployment, admin operations
图 11. 授权策略(gateway/policies.yaml)
我最坚持的一项设计决策是策略应该放在哪里执行。一个简单做法是在网关一次性校验权限后信任下游所有组件,但我们没有这么做。基于 FastMCP 构建的每一个 MCP 服务器都是独立的资源服务:每次工具调用前独立校验令牌并核对策略,见图 12。
from fastmcp.server.middleware import Middleware, MiddlewareContextclass AuthzMiddleware(Middleware):"""Deny tool calls whose caller role isn't permitted by the policy."""async def on_call_tool(self, context: MiddlewareContext, call_next):tool_name = context.message.nameauth_header = get_http_headers(include={"authorization"}).get("authorization")try:claims = decode_token(token_from_header(auth_header))except AuthError as exc:raise ToolError(f"Unauthorized: {exc}")role = claims.get("role", "")if not policy_engine.can_access_tool(role, tool_name):logger.warning("MCP authz DENY role=%r tool=%r", role, tool_name)raise ToolError(f"Forbidden: role '{role}' is not authorized to use tool '{tool_name}'")return await call_next(context)
图 12. AuthzMiddleware 校验入口(mcp_server/authz_middleware.py)
大模型可观测性
标准 APM 应用程序性能监控是我们踩过代价最大的坑。延迟、错误率、吞吐量只能判断模型是否连通,但完全看不出模型的行为是否正常。
生产级大模型系统真正需要这些指标:
幻觉率:AI 响应中违反格式规则(Schema 失败)或编造文档不存在事实(溯源失败)的占比,按照应用、提示词版本进行统计。
提示词漂移:不同提示词版本之间行为的变化率。新版本如果幻觉率提升 2%,在上线前就必须被发现。
成本优化:按照团队、应用、场景拆分 Token 开销,自动定位高开销场景。
工具调用行为:智能体调用哪些工具、调用顺序、失败率、拒绝率。多智能体流水线问题往往会在这里暴露出来。
行为正确性采样:对线上流量进行采样,基于标准基准进行离线评估,见后文“评估智能体行为”一节。
采集单请求成功率、用户维度延迟,把 AI 语义质量和传统运维指标关联起来。
实现“按团队统计”的关键点:必须在请求入口就写入团队标识数据,不能事后从日志重建。采集器根据认证角色解析出团队信息,存入请求入口设置的上下文变量。每一条记录都可追溯归属,业务代码不需要到处传递团队 ID。图 13 展示了归属关系:角色映射至团队,用户的请求、Token 消耗、成本、幻觉计数汇总到单条用户记录上。
ROLE_TEAM: dict[str, str] = {"viewer": "shared","analyst": "analytics","developer": "developer","deployer": "devops","admin"本文来源:InfoQ