像改文字一样改语音:火山引擎全新语音内容编辑模型
点击查看原文>
一段视频已经拍好,剪辑、配乐、字幕都已完成,却在最后检查时发现:口播里有一个词说错了。
重录,意味着重新找状态、重新进棚、重新对齐画面;补录,又要处理音色差异、语气断层和前后衔接。原本只是改几个字,却常常牵动整条内容生产链路。
火山引擎多媒体实验室通过全新语音内容编辑模型,把这件事变得更轻:让用户用自然语言指令表达“要改什么”,把“怎么自然地改进原声音”交给模型。
为什么是现在:语音编辑正在从“后期工程”走向“AI 内容编辑”
过去,音频后期更多围绕降噪、剪切、拼接、重录展开;而新一代 AI 音频工具正在把编辑对象从“波形片段”推进到“可理解、可改写的语音内容”。例如 Descript 将音视频编辑做成类似文档编辑的体验,强调可以通过编辑脚本来修正语音错误,并用 Regenerate 生成能融入上下文的新说话人音频。
Meta 的 Voicebox 研究也将语音生成能力拓展到内容编辑、风格迁移、降噪和多样化采样等任务,并强调模型可以替换说错的词,而不必重新录制整段语音。
这说明一个清晰趋势:创作者真正需要的,不只是“把声音做干净”,而是能够像改文字一样,低成本、低打扰地修改已经完成的音视频内容。
从“修音质”到“改内容”
不只处理噪声、混响和清晰度,更要能改正语音里真实说出的信息。
从“重录”到“局部再生成”
不再为了一个词返工整条视频,而是定位问题片段并生成自然替换。
从“专业后期”到“自然语言指令”
用户不必理解复杂音频工具,只需要说明“把 A 改成 B”。
核心能力:改内容,也保留原来的“人味”
语音编辑真正难的地方,不只是把新台词“念出来”,而是让它听起来仍然像原来那个人、在原来那段语境里自然说出来。
围绕这一目标,我们基于自研底座构建了指令驱动的语音内容编辑模型。模型同时理解原声音频与用户修改意图,不仅学习“败血症 → 坏血病”“极速款 → 极速版”这样的内容替换关系,也会利用原音频中的上下文信息,尽量延续说话人的音色、韵律和表达方式。
更直接
不用拆解复杂流程,直接用自然语言描述修改意图。
更自然
不只合成新片段,还要接回原语境,减少突兀感。
更高效
面向口播纠错、广告改词、配音调整和存量素材再编辑,降低重录成本。
从口播纠错、产品信息修订,到广告素材改词、配音微调和存量视频再编辑,用户只需要表达“把什么改成什么”。模型则以内容正确、音色保持、韵律自然、衔接顺滑为优化目标,让一次小修改不再变成一次大返工。
行业参考:我们补上的,是“语音内容可编辑”这一环
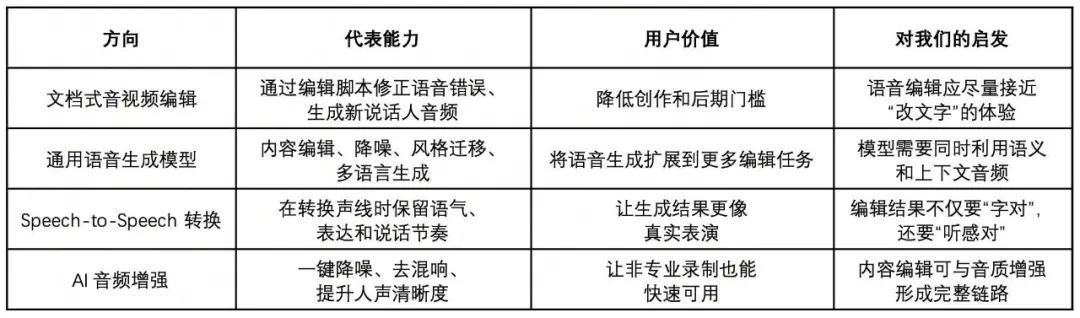
ElevenLabs 的 Voice Changer 文档强调,Speech-to-Speech 可以在转换声音时保留原始输入的 tone、delivery 和 speaking cadence,并可用于修正发音问题。Adobe Podcast Enhance Speech 则主打一键提升语音清晰度、去除噪声和回声,让普通环境录制的人声听起来更接近专业录音室效果。
这些能力共同指向一个更完整的内容生产链路:音质可以被增强,声线可以被迁移,而语音里的具体内容也应该可以被精准编辑。我们的语音内容编辑模型正是补上“内容可编辑”这一关键环节。
技术原理:让模型听懂原音频,也听懂修改指令
💬模型的核心思路可以概括为:先把声音转成可建模的音频 Token,再结合自然语言指令完成语义规划,最后生成修改后的语音结果。
统一表示:把声音和指令放进同一个生成框架
原音频会先经过音频 Tokenizer,转换为离散的音频 Token 序列,再与自然语言编辑指令一起输入模型。这样,模型处理的不是一份孤立的文字转写,而是能同时参考原始声音上下文和用户修改意图。
CoT 式语义规划:先想清楚怎么改,再生成声音
模型的分阶段生成可以理解为“语义先行”:先形成修改后的语义表达,再基于这一中间表示继续生成音频 Token,最后由声码器还原为波形。
语义规划与语音生成位于同一自回归序列中;在解码阶段,模型还会引入原音频的声学特征与说话人特征作为参考,帮助修改后的片段更好地贴合原说话人的声音特点。
成对编辑数据:学习真实场景里的“怎么改”
训练样本由原音频、编辑指令、修改后的语义表达和语音结果组成。模型通过监督微调学习从“原语音 + 修改指令”到“编辑后语音”的映射关系。训练时只对输出部分计算损失,不把输入提示当作预测目标,从而聚焦学习编辑结果本身。
效果展示:一句指令,完成声音内容修改
展示一|口播纠错:把“败血症”改成“坏血病”
修改指令:
把“败血症”改成“坏血病”。目标是在不重录整段口播的前提下,完成局部内容纠错,并尽量保持原声音色与前后表达连贯。
原视频:
基于重合成方案:
自研编辑模型修改后的视频:
展示二|广告视频改词:把“极速款”改成“极速版”
修改指令:
把“极速款”改成“极速版”。适用于广告投放、产品命名、活动信息等需要快速修订的内容场景。
原视频:
自研编辑模型修改后的视频:
适用场景:从一个词,到一批存量素材
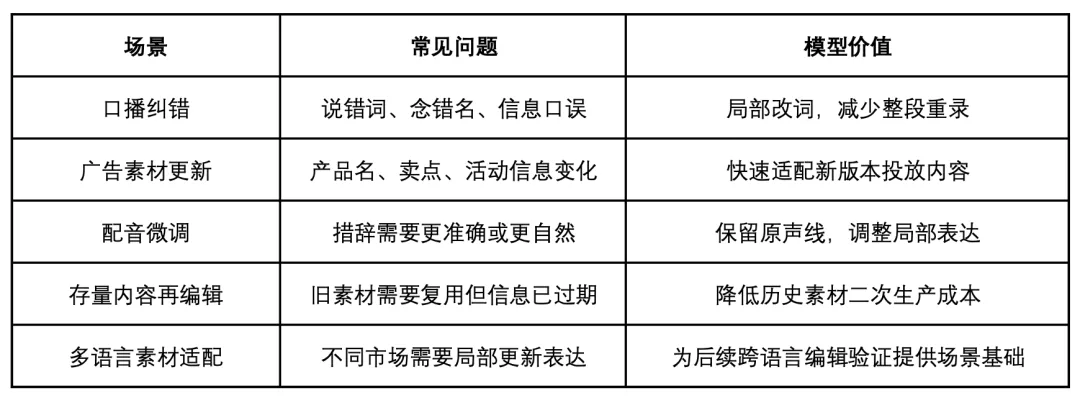
过去,口播错误意味着“重新录”;现在,我们希望把它变成“直接改”。
下一步:走向更稳定、更一致的内容编辑
接下来,我们会继续围绕真实素材中的指令执行、音色保持、韵律自然度和片段衔接效果进行听测与迭代。
更多素材
覆盖口播、广告、课程、解说等不同内容形态。
更多语言
持续验证中文、英文及后续多语言场景下的稳定性。
更多评测
从内容准确性、音色一致性、自然度和衔接感四个方向持续优化。
欢迎带着真实素材参与测试。用修改前后的对照,检验内容是否改对,也检验声音是否依然自然。我们希望让音视频内容修改从“重新制作一次”,变成“直接说明要改哪里”。
让用户说清楚“要改什么”,让模型承担更多“怎么改”的工作。
本文来源:InfoQ